Vom ER-Modell zum Datenbankschema
Normalisierung gilt als akademisch - ein Ruf, den sie sich verdient hat, weil sie als fünf nummerierte Regeln gelehrt wird statt als eine wiederholt gestellte Frage: gehört diese Tatsache hierher?
11 Min. LesezeitER - crow's foot3 von 3
Die kurze Antwort
- Dritte Normalform in einem Satz: jede Nichtschlüsselspalte hängt vom Schlüssel ab, vom ganzen Schlüssel und von nichts als dem Schlüssel.
- Ein Surrogatschlüssel überlebt es, wenn das Geschäft seine Meinung darüber ändert, was etwas identifiziert - und das tut es irgendwann.
- Denormalisieren Sie erst nach der Messung des Lesepfads. Davor tauschen Sie eine Korrektheitsgarantie gegen einen unbestätigten Gewinn.
- ER nach SQL ist mechanisch: Entität zu Tabelle, eins-zu-viele zu einem Fremdschlüssel auf der Viele-Seite, n:m zu einer eigenen Tabelle.

01Die Tabelle, mit der alle anfangen#
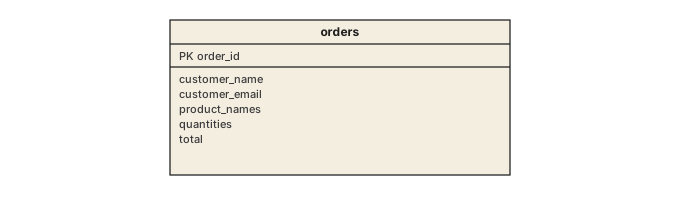
Das ist kein Strohmann - es ist die Form, die eine Tabellenkalkulation hat, und mit einer Tabellenkalkulation fangen die meisten Schemata an. Es lohnt sich, genau zu benennen, was daran falsch ist, denn "sie ist nicht normalisiert" erklärt nichts:
Was folgt, ist Datenbankschema-Modellierung im ganz gewöhnlichen Sinn: entscheiden, welche Tabellen es gibt, welche Spalte eine Zeile identifiziert und wo eine Tatsache wohnen darf. Es ist der Schritt zwischen einem ER-Diagramm und DDL, das eine Datenbank annimmt, und er lohnt sich auf Papier, weil jede dieser Entscheidungen teuer rückgängig zu machen ist, sobald Daten in der Tabelle stehen.
- Sie können keinen Kunden speichern, der nichts bestellt hat. Der Kunde existiert nur als Spalten auf einer Bestellung.
- Eine E-Mail zu korrigieren heißt, jede Zeile zu ändern, auf der dieser Kunde vorkommt - und eine übersehene Zeile lässt die Datenbank zwei verschiedene Antworten halten.
- Die letzte Bestellung zu löschen löscht den Kunden. Information verschwindet als Nebenwirkung von etwas Unverwandtem.
product_namesenthält eine Liste. Ab jetzt zerlegt jede Abfrage, die ein einzelnes Produkt braucht, eine Zeichenkette, und kein Index kann helfen.totalkann den Positionen widersprechen, deren Summe es sein soll.
Diese fünf haben Namen - Einfüge-, Änderungs- und Löschanomalie, eine Wiederholungsgruppe und ein abgeleiteter Wert - und Normalisierung ist schlicht das Verfahren, das sie beseitigt.
02Zuerst die Schlüssel wählen#
Alles Weitere hängt davon ab, also kommt es vor den Tabellen. Ein Primärschlüssel muss eindeutig sein, nie null und sich nie ändern. Die dritte Bedingung ist die, die die meisten Kandidaten ausscheidet.
| Element | Notation | Was es bedeutet |
|---|---|---|
| Surrogatschlüssel | bigint oder uuid | Erzeugt, bedeutungslos, für immer stabil. Der Standardfall. Eine fortlaufende Ganzzahl ist kompakt und indexfreundlich; eine UUID kann der Client erzeugen und verrät keine Mengen. |
| Natürlicher Schlüssel | ISBN, IBAN, Ländercode | Bedeutungstragend, und nur dann sicher, wenn eine Normungsorganisation garantiert, dass er sich nicht ändert. Wirklich infrage kommt nur eine kurze Liste. |
| Zusammengesetzter Schlüssel | zwei oder mehr Spalten | Richtig für Verbindungstabellen, wo das Paar aus Fremdschlüsseln die Identität ist und zugleich die Eindeutigkeitsbedingung, die Sie ohnehin wollten. |
| Fachlicher Schlüssel | Bestellnummer, SKU | Für Menschen bestimmt, muss eindeutig sein und sollte eine UNIQUE-Bedingung sein statt der Primärschlüssel - damit er sich korrigieren lässt, wenn sich ein Tippfehler darin findet. |
03Normalisierung in drei Schritten#
Es gibt sechs Normalformen und Sie brauchen drei. Jede ist eine einzige Frage an eine Tabelle, und die Antwort "nein" sagt Ihnen, welche Spalte wohin gehört.
| Element | Notation | Was es bedeutet |
|---|---|---|
| Erste Normalform | keine Wiederholungsgruppen | Jede Spalte hält einen Wert. Keine kommagetrennten Listen, kein product_1 / product_2 / product_3. Der sich wiederholende Teil bekommt eine eigene Tabelle. |
| Zweite Normalform | keine partiellen Abhängigkeiten | Jede Nichtschlüsselspalte hängt vom ganzen Schlüssel ab. Nur bei zusammengesetzten Schlüsseln überhaupt ein Thema: ein Produktname auf einer (order_id, product_id)-Tabelle hängt am halben Schlüssel, gehört also zu products. |
| Dritte Normalform | keine transitiven Abhängigkeiten | Keine Nichtschlüsselspalte hängt von einer anderen Nichtschlüsselspalte ab. Eine customer_email auf einer Bestellung hängt am Kunden, nicht an der Bestellung. Verschieben Sie sie nach customers. |
Die alte Zusammenfassung ist immer noch die beste: jede Nichtschlüsselspalte hängt vom Schlüssel ab, vom ganzen Schlüssel und von nichts als dem Schlüssel.
Schicken Sie die flache Tabelle hindurch. 1NF spaltet product_names und quantities in eine order_lines-Tabelle auf, eine Zeile je Produkt. 2NF bemerkt, dass Name und Preis eines Produkts nur am Produkt hängen, also erscheint products. 3NF bemerkt, dass Kundenname und E-Mail am Kunden hängen statt an der Bestellung, also erscheint customers. Vier Tabellen, also genau das Titeldiagramm - und kein Schritt verlangte ein Urteil, nur die Frage.
04Abgeleitete Werte und Denormalisierung#
Die Spalte total in der flachen Tabelle ist ein anderes Problem als die übrigen vier: sie steht nicht am falschen Ort, sie ist redundant. Sie lässt sich aus den Bestellpositionen berechnen, kann ihnen also widersprechen - und wird es irgendwann.
Drei legitime Antworten, nach Vorzug geordnet: in der Abfrage berechnen; in einer Sicht berechnen; speichern und die Datenbank pflegen lassen - eine generierte Spalte, eine materialisierte Sicht oder ein Trigger. Nicht legitim ist, sie zu speichern und darauf zu bauen, dass Anwendungscode ans Aktualisieren denkt; das ist die Variante, die Rechnungen erzeugt, die nicht aufgehen.
Dazu greifen, wenn
- Ein gemessener Lesepfad ist zu langsam und der Join ist nachweislich die Ursache
- Der Wert ist eine Momentaufnahme, keine Ableitung - der Preis zum Bestellzeitpunkt
- Eine Reporting-Tabelle, von einem geplanten Job gefüllt und klar so benannt
- Die Datenbank kann die Kopie selbst pflegen, sie kann also nicht auseinanderlaufen
Zu etwas anderem greifen, wenn
- Es könnte später langsam werden - erst messen, meist ist es das nicht
- Anwendungscode muss daran denken, die Kopie mitzuführen
- Das Duplikat ist zugleich die Wahrheitsquelle für etwas anderes
- Sie denormalisieren das transaktionale Schema, um ein Dashboard zu bedienen
05Vererbung modellieren#
Ein ER-Modell kann einen Obertyp mit Untertypen ausdrücken; eine relationale Datenbank hat kein solches Konstrukt, also muss das physische Modell eines von drei Layouts wählen. Alle drei sind weit verbreitet und die Wahl ist ein echter Tausch.
| Element | Notation | Was es bedeutet |
|---|---|---|
| Eine Tabelle | eine Tabelle, eine Typspalte | Die Spalten aller Untertypen in einer Tabelle, die meisten davon null. Einfache Abfragen, keine Joins - und die Datenbank kann "eine Scheckzahlung braucht eine Bankleitzahl" nicht erzwingen. |
| Tabelle je Untertyp | je eine Tabelle, gemeinsamer Schlüssel | Eine Elterntabelle mit den gemeinsamen Spalten und eine Kindtabelle je Untertyp, darauf verschlüsselt. Bedingungen funktionieren richtig; jede Abfrage joint. |
| Tabelle je konkretem Typ | vollständig getrennte Tabellen | Gar keine gemeinsame Tabelle. Schnell und sauber je Untertyp - und "alle Zahlungen" abzufragen heißt eine Union, die mit jedem neuen Untertyp wächst. |
Eine grobe Regel: wenige Untertypen mit überwiegend gemeinsamen Spalten sprechen für eine Tabelle; viele Untertypen mit auseinanderlaufenden Spalten und echten Bedingungen sprechen für Tabelle je Untertyp; und Untertypen, die nie zusammen abgefragt werden, sprechen für getrennte Tabellen. Das Klassendiagramm derselben Domäne hat die Vererbung meist gewählt, ohne irgendetwas davon zu betrachten - und genau deshalb dürfen die beiden Modelle hier voneinander abweichen.
06Der Weg zum DDL#
Ein logisches ER-Modell bildet sich fast mechanisch auf DDL ab, was der Lohn dafür ist, es ordentlich gezeichnet zu haben:
| Element | Notation | Was es bedeutet |
|---|---|---|
| Entität | CREATE TABLE | Eine Tabelle. Tabellenname im Plural, Entitätsname im Singular - entscheiden Sie sich einmal und bleiben Sie dabei. |
| Primärschlüssel | PRIMARY KEY | Impliziert not null und unique und legt den Index an. |
| Beziehung | REFERENCES | Ein Fremdschlüssel auf der Viele-Seite. Den Index legen Sie selbst an - die meisten Datenbanken erzeugen für einen Fremdschlüssel keinen, und sein Fehlen lässt Löschvorgänge kriechen. |
| Pflichtende | NOT NULL | Der innere Strich im Krähenfuß ist genau diese Bedingung. |
| Eins-zu-eins | UNIQUE auf dem Fremdschlüssel | Sonst ist es eine Eins-zu-viele-Beziehung, die bisher zufällig eine Zeile hat. |
| Verbindungsentität | zusammengesetzter PRIMARY KEY | Beide Fremdschlüssel gemeinsam. Genau das verhindert, dass dasselbe Paar zweimal erfasst wird. |
Zwei Dinge, die das Diagramm nicht sagt und das DDL entscheiden muss: was beim Löschen passiert (CASCADE bei einer identifizierenden Beziehung, RESTRICT bei fast allem anderen) und welche Spalten über die Schlüssel hinaus Indizes bekommen. Beides sind Entscheidungen über Verhalten und Last, nicht über das Modell, und beides schreibt man besser neben das Schema, als es später im Log langsamer Abfragen zu entdecken.
07Häufige Fehler#
- Über den Punkt der Nützlichkeit hinaus normalisieren. 3NF ist das Ziel für ein transaktionales Schema. Eine Tabelle zu spalten, weil sich eine Spalte vielleicht eines Tages wiederholt, bringt nichts und kostet für immer einen Join.
- Keine Fremdschlüssel, "wegen der Performance". Der Preis ist ein Indexzugriff beim Schreiben; der Nutzen ist, dass verwaiste Zeilen unmöglich werden. Fast nie der richtige Tausch.
- Nullbare Spalten als Ersatz für eine fehlende Tabelle. Sechs Spalten, die nur für eine Art von Zeile gefüllt sind, sind ein Untertyp, der eine eigene Tabelle will.
statusals freier Text. Schränken Sie ihn ein - eine Check-Bedingung, ein Enum oder eine Nachschlagetabelle - sonst enthält er binnen eines Jahresshipped,ShippedundSHIPPED.- Zeitstempel ohne Zeitzone. Genau einmal richtig, in einem Büro, bis der erste Server umzieht.
- Das nach der ersten Migration zurückgelassene Diagramm. Ein Schemadiagramm, das der Datenbank widerspricht, ist schlimmer als keines, weil die Leute ihm glauben.
Wenn die Kardinalitätssymbole in den Diagrammen oben Entschlüsselung brauchen: sie sind in der Krähenfuß-Notation behandelt; die Form des Modells selbst steht in den ER-Diagrammen.
In je einer Zeile
- 01Wählen Sie die Schlüssel vor den Tabellen; eindeutig, not null und nie wechselnd.
- 02Jede Nichtschlüsselspalte hängt vom Schlüssel ab, vom ganzen Schlüssel und von nichts als dem Schlüssel.
- 031NF spaltet Wiederholungsgruppen, 2NF behebt partielle Schlüssel, 3NF verschiebt fehlplatzierte Tatsachen.
- 04Denormalisieren Sie auf Messung hin, und nur dort, wo die Datenbank die Kopie pflegt.
- 05Ein historischer Preis ist kein Duplikat - er ist eine andere Tatsache.
- 06Der Krähenfuß bildet sich fast mechanisch auf DDL ab; indizieren Sie Ihre Fremdschlüssel.
08Häufige Fragen#
Was ist die dritte Normalform?
Eine Tabelle ist in dritter Normalform, wenn jede Nichtschlüsselspalte vom Schlüssel abhängt, vom ganzen Schlüssel und von nichts als dem Schlüssel. In der Praxis: keine Wiederholungsgruppen, keine Spalte, die nur von einem Teil eines zusammengesetzten Schlüssels abhängt, und keine Spalte, die von einer anderen Nichtschlüsselspalte abhängt.
Was unterscheidet Surrogatschlüssel und natürlichen Schlüssel?
Ein natürlicher Schlüssel sind Daten, die die Zeile ohnehin identifizieren, etwa eine ISBN. Ein Surrogatschlüssel ist ein bedeutungsloser erzeugter Wert wie eine Ganzzahl oder eine UUID. Surrogate bleiben stabil, wenn das Geschäft seine Meinung darüber ändert, was etwas identifiziert - und das tut es irgendwann.
Wann ist Denormalisierung gerechtfertigt?
Wenn Sie einen Lesepfad gemessen haben, den die Normalisierung zu langsam gemacht hat, und Sie damit leben können, dass der duplizierte Wert veraltet. Vor dieser Messung zu denormalisieren tauscht eine Korrektheitsgarantie gegen einen Leistungsgewinn, dessen Existenz Sie nicht bestätigt haben.
Wie setzt man Vererbung in einem relationalen Schema um?
Drei Möglichkeiten: eine Tabelle für die ganze Hierarchie mit einer Diskriminatorspalte und vielen nullbaren Spalten, eine Tabelle je konkreter Klasse mit wiederholten gemeinsamen Spalten, oder eine Tabelle je Klasse, über einen gemeinsamen Schlüssel verbunden. Was richtig ist, hängt davon ab, wie oft Sie über die Hierarchie hinweg abfragen, gegenüber dem, wie stark sich die Unterklassen unterscheiden.
Wie macht man aus einem ER-Diagramm SQL?
Jede Entität wird eine Tabelle, jedes Attribut eine Spalte und das identifizierende Attribut der Primärschlüssel. Eins-zu-viele-Beziehungen werden ein Fremdschlüssel auf der Viele-Seite, n:m-Beziehungen eine eigene Tabelle. Danach ergänzen Sie die Not-Null- und Unique-Bedingungen, die die Kardinalitäten des Diagramms nahelegen.
In dieser Reihe
- 01ER-Diagramme
- 02Krähenfuss-Notation
- 03Schemaentwurf
Passend dazu
Grundlagen
Notationsreferenz
Strukturdiagramme
Strukturdiagramme