Od ER modelu k databázovému schématu
Normalizace má pověst akademické disciplíny, kterou si vysloužila tím, že se učí jako pět očíslovaných pravidel místo jediné opakované otázky: patří tenhle údaj sem?
11 min čteníER - crow's foot3 z 3
Krátká odpověď
- Třetí normální forma v jedné větě: každý neklíčový sloupec závisí na klíči, celém klíči a ničem kromě klíče.
- Náhradní klíč přežije, když si byznys rozmyslí, co vlastně něco identifikuje - a to si nakonec rozmyslí vždy.
- Denormalizujte až po změření cesty čtení. Před měřením vyměňujete záruku správnosti za nepotvrzený přínos.
- Převod z ER do SQL je mechanický: entita na tabulku, jeden k mnoha na cizí klíč na straně mnoha, mnoho k mnoha na vlastní tabulku.

01Tabulka, kterou začíná každý#
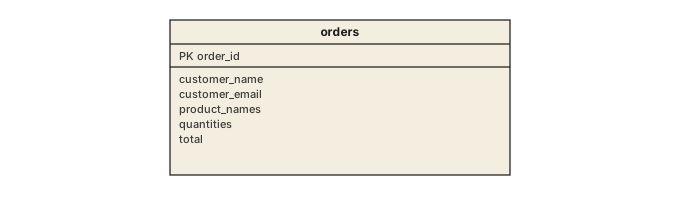
Tohle není vymyšlený protivník - je to tvar, který má tabulkový list, a tabulkovým listem většina schémat začíná. Vyplatí se přesně pojmenovat, co je na něm špatně, protože "není normalizovaná" nevysvětluje nic:
To, co následuje, je modelování databázového schématu v úplně běžném smyslu: rozhodnout, jaké budou tabulky, který sloupec identifikuje řádek a kde smí fakt bydlet. Je to krok mezi ER diagramem a DDL, které databáze přijme, a vyplatí se udělat ho na papíře, protože každé z těchto rozhodnutí se draze vrací zpět, jakmile jsou v tabulce data.
- Nemůžete uložit zákazníka, který si nic neobjednal. Zákazník existuje jen jako sloupce na objednávce.
- Oprava e-mailu znamená aktualizovat každý řádek, na kterém zákazník vystupuje - a když jeden vynecháte, databáze drží dvě různé odpovědi.
- Smazání poslední objednávky smaže zákazníka. Informace zmizí jako vedlejší účinek něčeho, co s ní nesouvisí.
product_namesobsahuje seznam. Odteď každý dotaz, který potřebuje jeden produkt, parsuje řetězec a žádný index mu nepomůže.totalmůže nesouhlasit s položkami, jejichž má být součtem.
Ta pětice má jména - vkládací, aktualizační a mazací anomálie, opakující se skupina a odvozená hodnota - a normalizace je prostě postup, který je odstraní.
02Nejdřív vyberte klíče#
Všechno další na tom závisí, takže to přichází dřív než tabulky. Primární klíč musí být jedinečný, nikdy null a nikdy se neměnit. Třetí podmínka je ta, která vyřadí většinu kandidátů.
| Prvek | Notace | Co znamená |
|---|---|---|
| Náhradní klíč | bigint nebo uuid | Generovaný, bezvýznamný, navždy stabilní. Výchozí volba. Sekvenční celé číslo je kompaktní a přátelské k indexům; UUID umí vygenerovat klient a neprozrazuje objemy. |
| Přirozený klíč | ISBN, IBAN, kód země | Významový, a bezpečný jen tehdy, když normalizační orgán garantuje, že se nezmění. Skutečně se kvalifikuje jen krátký seznam. |
| Složený klíč | dva nebo více sloupců | Správný pro spojovací tabulky, kde dvojice cizích klíčů je identitou a zároveň omezením jedinečnosti, které jste tak jako tak chtěli. |
| Byznysový klíč | číslo objednávky, SKU | Určený lidem, musí být jedinečný a měl by být omezením UNIQUE, ne primárním klíčem - aby se dal opravit, když se v něm najde překlep. |
03Normalizace ve třech krocích#
Normálních forem je šest a potřebujete tři. Každá je jediná otázka o tabulce a odpověď "ne" vám řekne, který sloupec kam přesunout.
| Prvek | Notace | Co znamená |
|---|---|---|
| První normální forma | žádné opakující se skupiny | Každý sloupec drží jednu hodnotu. Žádné seznamy oddělené čárkami, žádné product_1 / product_2 / product_3. Opakující se část rozdělte do vlastní tabulky. |
| Druhá normální forma | žádné částečné závislosti | Každý neklíčový sloupec závisí na celém klíči. Problém výhradně u složených klíčů: název produktu v tabulce (order_id, product_id) závisí na polovině klíče, takže patří do products. |
| Třetí normální forma | žádné tranzitivní závislosti | Žádný neklíčový sloupec nezávisí na jiném neklíčovém sloupci. customer_email na objednávce závisí na zákazníkovi, ne na objednávce. Přesuňte ho do customers. |
Staré shrnutí je pořád nejlepší: každý neklíčový sloupec závisí na klíči, celém klíči a ničem kromě klíče.
Proveďte přes ně plochou tabulku. 1NF rozdělí product_names a quantities do tabulky order_lines, jeden řádek na produkt. 2NF si všimne, že název a cena produktu závisí jen na produktu, takže se objeví products. 3NF si všimne, že jméno a e-mail zákazníka závisí na zákazníkovi, ne na objednávce, takže se objeví customers. Čtyři tabulky, což je právě titulní diagram - a žádný krok nevyžadoval úsudek, jen tu otázku.
04Odvozené hodnoty a denormalizace#
Sloupec total v ploché tabulce je jiný problém než ostatní čtyři: není špatně umístěný, je nadbytečný. Dá se spočítat z položek objednávky, takže s nimi může nesouhlasit - a jednou nesouhlasit bude.
Tři legitimní odpovědi v pořadí podle preference: počítat ho v dotazu; počítat ho v pohledu; uložit ho a nechat databázi, ať ho udržuje - generovaný sloupec, materializovaný pohled nebo trigger. Legitimní není uložit ho a spoléhat, že si aplikační kód vzpomene ho aktualizovat; to je verze, která produkuje faktury, které nesedí.
Sáhněte po něm, když
- Změřený vzorec čtení je příliš pomalý a spojení je prokazatelně příčinou
- Hodnota je snímkem v čase, ne odvozením - cena v okamžiku objednání
- Reportovací tabulka plněná naplánovanou úlohou, jasně takto pojmenovaná
- Databáze si kopii umí udržovat sama, takže se nemůže rozejít
Sáhněte po něčem jiném, když
- Mohlo by to být pomalé později - nejdřív měřte, obvykle to pomalé není
- Aplikační kód si musí pamatovat, že kopii má držet v souladu
- Duplikát je zároveň zdrojem pravdy pro něco jiného
- Denormalizujete transakční schéma kvůli obsluze dashboardu
05Modelování dědičnosti#
ER model umí vyjádřit nadtyp s podtypy; relační databáze takovou konstrukci nemá, takže fyzický model musí vybrat jedno ze tří rozložení. Všechna tři se široce používají a volba je skutečným kompromisem.
| Prvek | Notace | Co znamená |
|---|---|---|
| Jedna tabulka | jedna tabulka, sloupec typu | Sloupce všech podtypů v jedné tabulce, většina z nich null. Jednoduché dotazy, žádná spojení - a databáze neumí vynutit "platba šekem musí mít kód banky". |
| Tabulka na podtyp | tabulka pro každý, sdílený klíč | Rodičovská tabulka se společnými sloupci a dceřiná tabulka na podtyp, navázaná na ni klíčem. Omezení fungují pořádně; každý dotaz se spojuje. |
| Tabulka na konkrétní typ | zcela oddělené tabulky | Žádná sdílená tabulka. Rychlé a čisté v rámci podtypu - a dotaz na "všechny platby" znamená unii, která roste s každým přidaným podtypem. |
Hrubé pravidlo: málo podtypů s převážně společnými sloupci mluví pro jednu tabulku; hodně podtypů s rozcházejícími se sloupci a reálnými omezeními mluví pro tabulku na podtyp; a podtypy, na které se nikdy nedotazujete společně, mluví pro oddělené tabulky. Diagram tříd pro tutéž doménu si dědičnost obvykle vybral, aniž by cokoli z tohohle řešil, a právě proto tyhle dva modely tady smějí být odlišné.
06Cesta k DDL#
Logický ER model se na DDL mapuje téměř mechanicky, což je odměna za to, že jste ho nakreslili pořádně:
| Prvek | Notace | Co znamená |
|---|---|---|
| Entita | CREATE TABLE | Jedna tabulka. Název tabulky v množném čísle, název entity v jednotném - vyberte si jedno a držte se toho. |
| Primární klíč | PRIMARY KEY | Implikuje not null a unique a vytváří index. |
| Vztah | REFERENCES | Cizí klíč na straně mnoha. Index si přidejte sami - většina databází ho pro cizí klíč nevytvoří a jeho absence zpomalí mazání na plazení. |
| Povinný konec | NOT NULL | Vnitřní čárka ve vraní noze je přesně tohle omezení. |
| Jeden k jednomu | UNIQUE na cizím klíči | Jinak je to vztah jeden k mnoha, který má zatím jen jeden řádek. |
| Spojovací entita | složený PRIMARY KEY | Oba cizí klíče dohromady. Právě to zabrání tomu, aby se tatáž dvojice zapsala dvakrát. |
Dvě věci, které vám diagram neřekne a DDL o nich musí rozhodnout: co se stane při mazání (CASCADE u identifikujícího vztahu, RESTRICT téměř všude jinde) a které sloupce dostanou indexy nad rámec klíčů. Obojí jsou rozhodnutí o chování a zátěži, ne o modelu, a obojí se vyplatí zapsat vedle schématu, ne je objevit později v logu pomalých dotazů.
07Časté chyby#
- Normalizování za hranici užitečnosti. 3NF je cíl transakčního schématu. Rozdělit tabulku proto, že se sloupec možná jednou zopakuje, nepřinese nic a bude stát spojení navždy.
- Žádné cizí klíče, "kvůli výkonu". Cena je jedno vyhledání v indexu při zápisu; přínosem je, že osiřelé řádky jsou nemožné. Skoro nikdy to není výměna, která se vyplatí.
- Nullovatelné sloupce zastupující chybějící tabulku. Šest sloupců, které jsou vyplněné jen pro jeden druh řádku, je podtyp, který si říká o vlastní tabulku.
statusjako volný text. Omezte ho - kontrolním omezením, enumem nebo číselníkovou tabulkou - jinak bude do roka obsahovatshipped,ShippediSHIPPED.- Časová razítka bez časové zóny. Správně přesně jednou, v jedné kanceláři, do prvního přesunu serveru.
- Diagram opuštěný po první migraci. Diagram schématu, který nesouhlasí s databází, je horší než žádný, protože mu lidé věří.
Pokud symboly kardinality na diagramech výše potřebují překlad, jsou pokryté v notaci vraní nohy; tvar samotného modelu je v ER diagramech.
Po jednom řádku na každé
- 01Klíče vyberte dřív než tabulky; jedinečné, not null a nikdy se neměnící.
- 02Každý neklíčový sloupec závisí na klíči, celém klíči a ničem kromě klíče.
- 031NF rozdělí opakující se skupiny, 2NF opraví částečné klíče, 3NF přesune špatně umístěné fakty.
- 04Denormalizujte na základě měření a jen tam, kde kopii udržuje databáze.
- 05Historická cena není duplikát - je to jiný fakt.
- 06Vraní noha se na DDL mapuje téměř mechanicky; indexujte si cizí klíče.
08Časté dotazy#
Co je třetí normální forma?
Tabulka je ve třetí normální formě, když každý neklíčový sloupec závisí na klíči, celém klíči a ničem kromě klíče. V praxi: žádné opakující se skupiny, žádný sloupec závislý jen na části složeného klíče a žádný sloupec závislý na jiném neklíčovém sloupci.
Jaký je rozdíl mezi náhradním a přirozeným klíčem?
Přirozený klíč jsou data, která řádek už identifikují, například ISBN. Náhradní klíč je bezvýznamná generovaná hodnota, například celé číslo nebo UUID. Náhradní klíče zůstanou stabilní, když si byznys rozmyslí, co vlastně něco identifikuje - a to si nakonec rozmyslí vždy.
Kdy je denormalizace opodstatněná?
Když jste změřili cestu čtení, kterou normalizace zpomalila příliš, a umíte žít s tím, že zduplikovaná hodnota zestárne. Denormalizovat dřív, než tu míru máte, znamená vyměnit záruku správnosti za výkonnostní přínos, o kterém jste si nepotvrdili, že existuje.
Jak se v relačním schématu implementuje dědičnost?
Tři možnosti: jedna tabulka pro celou hierarchii s rozlišovacím sloupcem a spoustou nullovatelných sloupců, jedna tabulka na konkrétní třídu se zopakovanými společnými sloupci, nebo jedna tabulka na třídu spojená přes sdílený klíč. Která je správná, závisí na tom, jak často se dotazujete napříč hierarchií, oproti tomu, jak moc se podtřídy liší.
Jak udělat z ER diagramu SQL?
Každá entita se stane tabulkou, každý atribut sloupcem a identifikující atribut primárním klíčem. Vztahy jeden k mnoha se stanou cizím klíčem na straně mnoha a vztahy mnoho k mnoha vlastní tabulkou. Pak přidejte omezení not null a unique, která kardinality na diagramu naznačují.
V této sérii
- 01ER diagramy
- 02Notace vraní nohy
- 03Návrh schématu
Související články
Základy
Přehled notace
Diagramy struktury
Diagramy struktury